Problem: W wyniku zmian organizacyjnych część zadań magazynowych została przeniesiona do zespołu planowania produkcji. W praktyce oznaczało to dodatkowe ~1,5–2 godziny manualnej pracy dziennie związanej z księgowaniami w SAP.
Przejęcie dodatkowych zadań do procesu nie jest kwestią tylko godziny czy dwóch godzin pracy dziennie. Ownership narzuca też odpowiedzialność za utrzymanie ciągłości np. w przypadku absencji pracownika. W niewielkim — wtedy czteroosobowym — zespole dodatkowe 2 godziny pracy manualnej to prawdziwe wyzwanie.
Wyzwaniem był nie tylko czas ale też wiedza. W dużym skrócie: proces ten polegał na przeszukiwaniu wyników transakcji VL10D oraz VL10C (planowane wysyłki), wybieraniu materiałów, które trzeba przeksięgować, a następnie dokonaniu tego księgowania. Logika była dość zawoalowana, a sama identyfikacja opierała się głównie na znajomości materiałów wynikającej z doświadczenia. Wprowadzenie nowej osoby w te niuanse wymagałoby tygodni, jeśli nie miesięcy.
Dodatkowo, wartość biznesowa tego procesu była niewielka. Z drugiej strony był on konieczny dla utrzymania porządku. Wpływał też bezpośrednio na terminowość dostaw niektórych części serwisowych do klientów.
Moja diagnoza była następująca:
- jest to “mały” proces, który generuje duży koszt,
- większość czasu (~90%) pochłania zbieranie danych do podjęcia decyzji, a nie sama decyzja,
- pomimo, że proces jest skomplikowany, to da się go uprościć,
- należy dążyć do sytuacji, w której pracownik dostaje możliwie krótką listę materiałów oraz wszystkie niezbędne do podjęcia decyzji dane, a następnie tylko decyduje, które z pozycji mają zostać przeksięgowane → wycięcie szumu informacyjnego do minimum
Podjąłem więc decyzję, żeby ten workflow przebudować, a zacząłem od jego zrozumienia i analizy oraz zdefiniowania stanu obecnego.
Najważniejsze wnioski z projektu
- Małe zadania generują często największy ukryty koszt operacyjny.
- W tym przypadku ~90% czasu pochłaniało zbieranie danych, a nie podejmowanie decyzji.
- Kluczowe było oddzielenie warstwy danych, decyzji i wykonania.
- Nie każdy proces warto automatyzować w 100% — human-in-the-loop znacząco zwiększa bezpieczeństwo.
- Największą wartością było zapisanie wiedzy procesowej w systemie, a nie tylko skrócenie czasu pracy.
- Automatyzacja skróciła czas operacji z ~90 minut do ~15 minut dziennie.
Analiza procesu — stan obecny
System nie był optymalny ze względu na problemy występujące na trzech różnych warstwach: operacyjnej, danych oraz decyzyjnej.
Największe wyzwania warstwy operacyjnej to:
- wiele transakcji (VL10D, VL10C, MIGO…)
- ręczne sprawdzanie każdej pozycji
Problemy w warstwie danych:
- brak jednego widoku
- dane rozproszone po systemie
- eksporty z transakcji VL10D/C są bardzo uciążliwe do analizowania ze względu na listę hierarchiczną.
Warstwa decyzyjna — pomimo, że reguły były zdefiniowane, to odpowiedzi na następujące pytania były nieoczywiste:
- co przeksięgować?
- kiedy?
- czy było to zrobione już wcześniej?
Nie próbowałem automatyzować tego procesu w obecnej formie. Najpierw musiałem go uprościć do modelu, który da się kontrolować. Pomogła w tym następująca analiza przeprowadzona w sposób metodyczny:
- Co jest wejściem?
- VL10D / VL10C
- Co jest wyjściem?
- decyzja: TAK / NIE
- Jakie pytania należy zadać?
- czy materiał zakupowy?
- czy już przeksięgowany?
- czy jest na stanie? na jakim składzie?
- Danych z których transakcji potrzebujemy, żeby odpowiedzieć na te pytania?
- MB52 (stany magazynowe i ilości wyrobów na poszczególnych składach)
- MB51 (historia księgowań)
- ZSBE (transakcja customizowana z danymi podstawowymi w tym rodzaj nabycia — zakupowy/produkcyjny)
Powyższa analiza wyłoniła pierwszą część procesu, która w dużej mierze opiera się na zbieraniu i analizowaniu danych. Na końcu mamy decyzję, po której następuje operacyjne księgowanie — druga część workflow:
- Co jest wejściem?
- decyzja: TAK / NIE
- Co jest wyjściem?
- Przeksięgowanie i inne operacje (MIGO, MB02, LT04, LT06)
Dzięki temu sprowadziłem ten proces do prostego modelu decyzyjnego, kontrolowanego przez człowieka. Dlaczego? Ponieważ jest on złożony, a błędne decyzje powodują bałagan w systemie ERP.
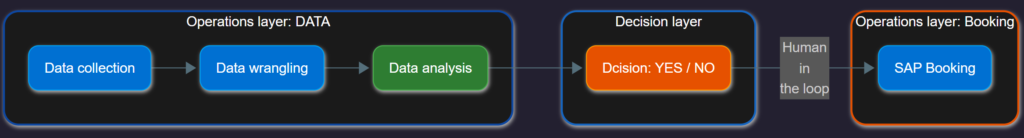
Dopiero mając tak uproszczony model, można było myśleć o automatyzacji.
W kolejnym rozdziale zagłębię się nieco mocniej w architekturę zastosowanego rozwiązania.
Zastosowane rozwiązanie
Rozwiązanie, które opracowałem to skrypt napisany w języku Python połączony z Excelem pełniącym warstwę decyzyjną. Tak zaprojektowany system składa się z czterech następujących etapów:
- Agregacja danych,
- Transformacja i filtrowanie,
- Human in the loop,
- Automatyczne księgowanie w SAP-ie i drukowanie dokumentów.
W praktyce wygląda to tak, że pracownik uruchamia pierwszy skrypt, który zbiera dane (krok 1). Po kilku minutach “dostaje” trzy otwarte pliki Excel z niezbędnymi danymi (podział na trzy pliki wynika z kontekstu biznesowego). Następnie potwierdza materiały do przeksięgowania (krok 2). Na koniec uruchamia skrypt wykonujący operacje księgowania w SAP na podstawie danych z tych trzech plików (krok 3).
Etap 1: Agregacja danych
Tak, jak pisałem wcześniej — decyzja o przeksięgowaniu wymaga wielu informacji z różnych źródeł (transakcji SAP). Skrypt w pierwszej kolejności otwiera te transakcje w SAP-ie i eksportuje dane do plików Excela. Wykorzystałem tutaj technologię SAP GUI Scripting, którą opisywałem już wcześniej na blogu w serii o Automatyzacji SAP-a (link do serii).
Głównym źródłem danych są transakcje VL10D oraz VL10C. Do każdego indeksu z tych tabel dodałem informacje z pozostałych transakcji (wykorzystałem m.in. bibliotekę pandas w Pythonie).
Etap 2: Transformacja i filtrowanie danych
Zasadniczo ten etap przenika się z poprzednim. Największym wyzwaniem, jest tutaj lista hierarchiczno-sekwencyjna z transakcji VL10D i VL10C. Uniemożliwia ona proste sortowanie i filtrowanie, a struktura danych jest bardzo nieczytelna:
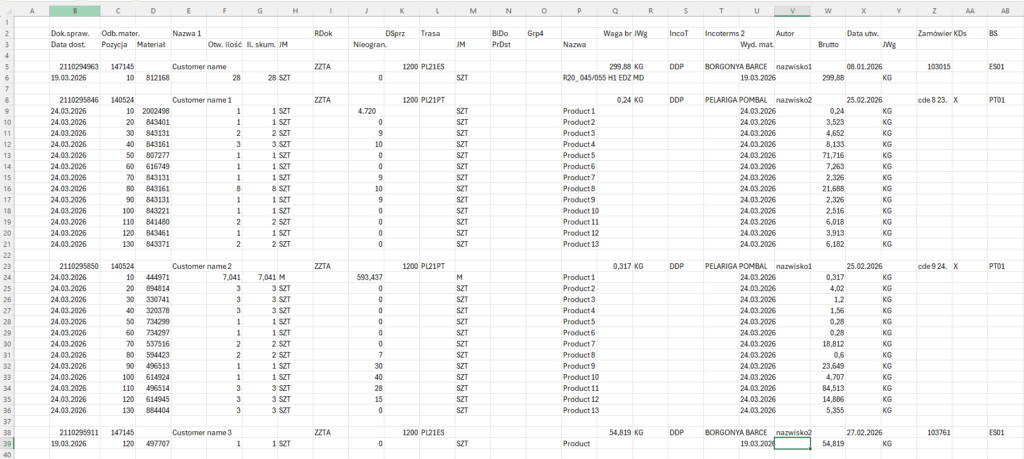
Powyższy rysunek pokazuje niewielki fragment takiej listy. W praktyce jest to kilka tysięcy wierszy, przez które użytkownik musi “przedzierać” się manualnie każdego dnia. Jest to prawdziwy problem dla każdego managera operacyjnego, ponieważ w ten sposób efektywność zespołów jest dosłownie przepalana.
Aby ustrukturyzować te informacje napisałem specjalny algorytm, który:
- usuwa zbędne wiersze oraz
- wypełnia brakujące dane.
W efekcie otrzymujemy płaską listę z uporządkowanymi nagłówkami i danymi.
W dalszym kroku można bez problemu rozszerzyć tabelę o dane z innych transakcji oraz odfiltrować zbędne wiersze. To tutaj cała wiedza o tym procesie jest “zaszyta” w program komputerowy, dzięki czemu użytkownik nie musi podejmować setek mikro-decyzji, a jedynie kontrolować efekt działania programu. Output programu przedstawiono na rysunku 3 — są to wyczyszczone i przefiltrowane dane z transakcji VL10C.
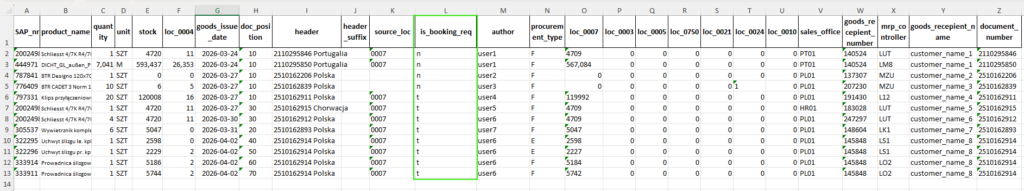
Lista z rys. 3 przedstawia rzeczywiste dane z produkcji i zawiera wszystkie indeksy, które były danego dnia istotne z punktu widzenia tego procesu. Jest ich zaledwie kilkanaście — i to tylko na nich musi skupić się odpowiedzialny specjalista. Cały szum informacyjny został “wycięty” wcześniej.
Na tym etapie zostały też przygotowane inne informacje podawane podczas księgowania w celu identyfikacji zleceń (np. header) oraz kolumna, w której pracownik potwierdza decyzję o księgowaniu.
Etap 3: Human in the loop
To podejście pozwala zweryfikować wyniki działania “automatu” przed wprowadzeniem zmian do systemu produkcyjnego. Ta koncepcja jest często wykorzystywana w implementacjach AI, opisywałem ją też w serii o Agentach AI (link).
Analiza tego konkretnego problemu pokazała, że mogą wystąpić trudne do przewidzenia przypadki brzegowe (ang. corner case). Dlatego też zaimplementowane rozwiązanie zakłada udział człowieka pomiędzy dwoma procesami, które zostały zautomatyzowane w 100%:
- zbieraniem i filtrowaniem danych oraz
- operacjami księgowania.
Pracownik dostaje trzy pliki Excel z możliwie krótką listę artykułów oraz dane niezbędne do podjęcia decyzji. Jedyne, co musi zrobić, to zaznaczyć te, które faktycznie powinny być przeksięgowane.
Mówiąc krótko — program dba o to, żeby lista zawierała wszystkie niezbędne indeksy. Może być ich więcej i w takim przypadku działa human in the loop “nie wpuszczając” tych artykułów do kolejnego etapu procesu.
Etap 4: Automatyczne księgowanie w SAP-ie
Na tym etapie mamy już wszystkie niezbędne dane. Została do wykonania czysto operacyjna część procesu w transakcjach MIGO, MB02, LT04 i LT06. W zastosowanym rozwiązaniu wszystkie te czynności realizowane są przez skrypt Python wykorzystujący SAP GUI Scripting.
Program pobiera dane z wszystkich trzech plików Excel i wykonuje księgowanie oraz inne niezbędne czynności w systemie SAP. Zapewnia przy tym odpowiednią kolejność operacji, dzięki temu wydrukowane dokumenty są gotowe do przekazania dalej bez konieczności ich ręcznego sortowania.
Wszystkie dane historyczne są zapisywane i archiwizowane tak, żeby łatwo można było do nich wrócić po czasie. Zwiększa to również poczucie posiadania kontroli nad procesem przez osobę odpowiedzialną.
Dla zainteresowanych — jak wygląda to technicznie, przedstawiam szczegółowy schemat procesu:
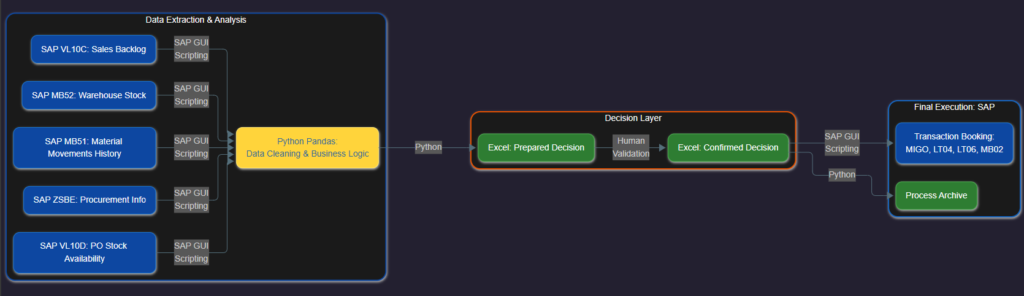
Powyższy schemat pokazuje implementację — ale warto zauważyć, że jego logika jest niezależna od technologii.
Podsumowanie
Dwie największe korzyści tego projektu to:
- Skrócenie czasu zadań operacyjnych z ~90 minut do około 15 minut.
- Zapisanie wiedzy o procesie w programie komputerowym — przed wdrożeniem osoba odpowiedzialna musiała mieć głęboką wiedzę procesową i produktową.
Wcześniej wszystko było w głowie pracownika. Teraz logika decyzyjna została zapisana w algorytmie. Instrukcja dla wszystkich tych operacji zajmowała kilkadziesiąt slajdów Power Point. Implementacja nowego rozwiązania umożliwiła zastąpienie jej krótkim standardem (7 stron).
Dzięki automatyzacji zarówno szczegóły techniczne wszystkich operacji, jak też dokładna wiedza produktowa nie są już potrzebne, ponieważ to program komputerowy dba o to, żeby odfiltrować nieistotne indeksy oraz kliknąć w SAP-ie właściwe przyciski i wprowadzić poprawne dane.
Opisane tutaj case study to klasyczny przykład wysokiego kosztu operacyjnego jednej małej decyzji. Takie małe procesy/zadania mogą “zjadać” organizację codziennie w sposób niezauważony. Taka refleksja skłania, aby zadać sobie następujące pytania:
- ile takich procesów masz w organizacji?
- kto je „po cichu wykonuje”?
- ile kosztują dziennie?
Nowy system robi coś bardzo ważnego — oddziela dane od decyzji. Dzięki czemu atencja specjalisty skupiona jest właśnie na wyodrębnionej warstwie decyzji, co niewątpliwie zwiększa efektywność procesu i eliminuje marnotrawstwo.
Przypadek, który opisałem nie jest wyjątkowy. W każdej organizacji istnieją dziesiątki takich procesów — małych, niewidocznych, ale kosztownych. Jest to szczególnie cenna informacja w kontekście szumu, jaki w ostatnim czasie powstał wokół AI. Identyfikacja i wyeliminowanie takiego marnotrawstwa może okazać się “nisko wiszącym jabłkiem”, po które warto sięgnąć zanim zdecydujemy się na większe — rewolucyjne — zmiany w procesach.