Problem: W dwóch zakładach produkcyjnych funkcjonowały różne pliki Excel wspierające planowanie produkcji w kilkumiesięcznym horyzoncie czasowym. Dane były przygotowywane ręcznie, interpretowane w różny sposób i nie dawały wspólnego obrazu operacji na poziomie zarządczym.
Jakiś czas temu podjąłem się więc pracy nad usystematyzowaniem planowania produkcji w dłuższym horyzoncie czasowym (kilka miesięcy). Projekt zakończył się uruchomieniem nowego procesu planowania średnioterminowego, którego celem jest podejmowanie optymalnych decyzji dotyczących:
- budowania zapasów magazynowych,
- definiowania celów produkcyjnych dla poszczególnych obszarów.
Nowy proces to przede wszystkim:
- struktura spotkań,
- ramy decyzyjne oraz
- narzędzie.
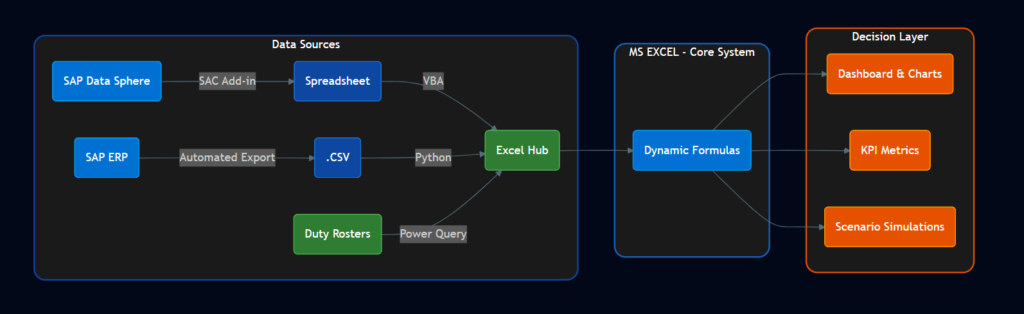
W tym artykule chciałbym się skupić na ostatnim elemencie tej procesowej konstelacji. Pokażę, jak za pomocą Excela, VBA oraz Pythona usystematyzować realny proces biznesowy, łącząc przy tym dane z SAP-a oraz Data Sphere.
Najważniejsze wnioski z projektu
- Wdrożono ustandaryzowany proces planowania produkcji dla dwóch zakładów produkcyjnych.
- Dane operacyjne są pobierane automatycznie z SAP Data Sphere oraz eksportów z systemu SAP.
- Excel pełni rolę huba analitycznego, w którym integrowane są dane z różnych źródeł.
- Obliczenia wskaźników KPI realizowane są przez skrypt Python (Pandas) uruchamiany z poziomu Excela.
- Narzędzie umożliwia symulacje poziomu zapasów w oparciu o cele produkcyjne, prognozowaną sprzedaż oraz aktualne dane operacyjne.
- Automatyzacja procesu skróciła przygotowanie danych dla 17 obszarów produkcyjnych do około 10 minut dziennie.
Stan obecny
W zarządzaniu operacjami kluczowe są dane. W prezentowanym tutaj studium przypadku zbierane były następujące informacje:
- produkcja [szt./dzień],
- wejście zamówień [szt./dzień],
- miesięczny cel sprzedażowy wynikający z budżetu [szt.].
Te trzy strumienie danych determinują poziom zapasu i obciążenie mocy produkcyjnych.
Dane dotyczące produkcji oraz wejścia zamówień przenoszono manualnie z dziennego raportu w SAC (Sap Analytics Cloud). Każda linia produkcyjna rozpatrywana była osobno (miała swój dedykowany arkusz). I dla każdej z nich definiowany był również cel produkcyjny na kolejne miesiące.
Naturalnie, na podstawie tych danych obliczano wskaźniki, takie jak:
- przewidywany poziom zapasu,
- realizacja celu sprzedażowego,
- miesięczne podsumowanie produkcji oraz wejścia zamówień,
- produkcja, wejście zamówień oraz cel sprzedażowy kumulacyjnie dla danego miesiąca.
Oczywiście, te bardziej istotne dane zostały zwizualizowane na wykresach.
Takie rozwiązanie wspierało podejmowanie decyzji, ale miało bardzo istotne ograniczenia. Wynikały one głównie z tego, że narzędzie powstało w wyniku ewolucji i stopniowego dokładania nowych rzeczy do pierwotnej — bardzo prostej — wersji pliku. Wśród największych ograniczeń wymieniłbym:
- brak standardu dla zakładów produkcyjnych — każda z fabryk miała swój plik, który wyglądał inaczej, a dane były interpretowane w różny sposób,
- obsługa plików była wymagająca i czasochłonna — wymagała ręcznego przepisywania danych z SAC, dopasowywania formuł i danych do wykresów podczas zmiany miesiąca, a także żmudnego przygotowywania czystych plików na kolejny rok,
- layout pliku był bardzo non-user-friendly — np.: techniczne, niepotrzebne informacje wyświetlane na pierwszym planie itd.,
- brak wskaźników KPI pokazujących sytuację z bieżącymi zamówieniami klientów na poziomie operacyjnym,
- niespójność danych — części serwisowe produkowane na liniach produkcyjnych (ich pracochłonność to około 80% pracochłonności wyrobu gotowego) nie są uwzględnione w danych wejścia zamówień,
- nieprecyzyjne symulacje zapasów — opierają się tylko na różnicy wejścia zamówień i ilości wyprodukowanych wyrobów w danym okresie (miesiąc), pomijają przy tym faktyczny stan zapasów oraz ilość otwartych zleceń klientów, które zostaną wysłane dopiero w kolejnym okresie (co zaburza całą matematykę).
Mówiąc krótko — brak jednego standardu dla różnych fabryk to katastrofa z punktu widzenia managera odpowiedzialnego za obydwa zakłady produkcyjne (poziom upper management). Z kolei brak odpowiednich KPI, niespójność danych oraz niedokładne symulacje stanowiły realną przeszkodę w dobrej komunikacji pomiędzy kierownikami produkcji oraz planowania (middle management). A na sam koniec — manualna obsługa plików to dodatkowe obciążenie na poziomie operacyjnym.
Pakiety robocze
Projekt podzieliłem na kilka pakietów roboczych — każdy z nich stanowił kamień milowy w drodze do osiągnięcia głównego celu. Poniżej przedstawiam je skrótowo, używając tylko haseł. W kolejnych rozdziałach — dotyczących zastosowanych rozwiązań oraz architektury — rozbroję niektóre z nich tak, żeby wydobyć esencję istotną z punktu widzenia usystematyzowania tego procesu.
- Wybór systemu — Excel. Dlaczego? W Excelu warstwa danych i warstwa prezentacji to ten sam arkusz. Dzięki temu bez problemu możemy np. dostosowywać cele produkcyjne (wpisując po prostu nową cyfrę), co w czasie rzeczywistym jest odzwierciedlone na wykresie. To dało możliwość natychmiastowej symulacji każdemu, kto ma dostęp do narzędzia.
- Layout narzędzia — na pierwszym planie zostają tylko najważniejsze — z punktu widzenia zarządzania operacjami — dane i informacje. Cała reszta zostaje przeniesiona do arkuszy pomocniczych. Na tym etapie było jasne jak będzie wyglądał arkusz, główne formuły oraz jakie dane będą zbierane. To ustandaryzowało cały proces.
- Poprawność danych — Dopieszczenie modelu danych w Data Sphere tak, żeby uwzględniał wszystkie wyroby przypisane do poszczególnych linii produkcyjnych zarówno po stronie wejścia zamówień, jak również ilości produkcji (potwierdzone zlecenia produkcyjne z systemu SAP). To zmniejszyło ryzyko niespójności danych.
- Automatyzacja pobierania danych — Jak pobierać dane z Data Sphere do tabeli w Excelu w sposób automatyczny, co skróciło czas potrzebny na obsługę pliku.
- Operacyjne KPI — określenie niezbędnych danych, opracowanie metody obliczeń oraz skryptu Python, który je realizuje. To dało pełny obraz sytuacji operacyjnej, jaką specjaliści widzą w SAP, z tym, że w formie syntetycznej, zarządczej.
- Eksport danych z SAP — Uruchomienie automatycznych eksportów z SAP-a, które codziennie o 5:00 rano zapewniają aktualne pliki Excel z danymi, które nie są dostępne w Data Sphere (albo ich pobieranie przez Data Sphere nie byłoby zasadne). To wyeliminowało problem ręcznego pobierania danych.
- Zarządzanie scenariuszowe — opracowanie makr VBA i architektury Excela, która umożliwia zapisanie dowolnego scenariusza oraz przełączanie się między nimi.
- Skalowalność — opracowanie mechanizmu, który umożliwi przygotowanie czystych arkuszy dla dowolnej ilości obszarów produkcyjnych, którymi chcemy zarządzać za pomocą pliku. To skróciło czas przygotowywania czystych plików przy wejściu w nowy rok lub dodawaniu kolejnych obszarów.
Zastosowane rozwiązania
W tym rozdziale wejdę nieco głębiej w zagadnienia wprowadzone przy okazji opisywania pakietów roboczych. A zacznę od elementu, który może wydawać się trywialny…
Layout narzędzia
W tego typu projektach bardzo często sprawdza się powiedzenie “mniej znaczy więcej”, bo mniej danych i informacji to więcej przejrzystości i koncentracja na tym, co naprawdę ważne.
Tylko niezbędne dane
Każdy, kto kiedykolwiek projektował jakiś produkt wie, jak ważne jest tzw. user experience, czyli doświadczenia użytkownika związane z korzystaniem z danego rozwiązania. W przypadku tego projektu ten aspekt był również niezwykle istotny.
Należy pamiętać o trzech rzeczach:
- W procesie planowania produkcji mamy do czynienia z dużą ilością danych.
- Celem narzędzia jest dostarczenie informacji niezbędnych do podejmowania decyzji.
- Z narzędzia będzie korzystał głównie management.
Wniosek? Niezwykle łatwo tutaj o “przeładowanie” danymi. Uważam, że Managerowie powinni widzieć jedynie esencję, która ma wpływ na decyzje. Wszystko ponadto jest tylko szumem informacyjnym.
W związku z powyższym dane takie jak:
- dane źródłowe do wykresów,
- obliczenia pośrednie,
- inne…
…trafiły do arkuszy pomocniczych.
Wykresy rozmieszczone są tak, żeby mieściły się na jednym widoku przy wystarczającym powiększeniu.
To wszystko pokazuje wyraźnie czysty obraz operacji.
Formatowanie
Czyli kolejna “błaha rzecz”, której warto poświęcić chwilę czasu:
- miesiące parzyste oddzielone od nieparzystych jasnym i ciemnym kolorem tła,
- dni świąteczne automatycznie podświetlające się na czerwono,
- aktualny miesiąc wyróżniony specjalnym formatowaniem.
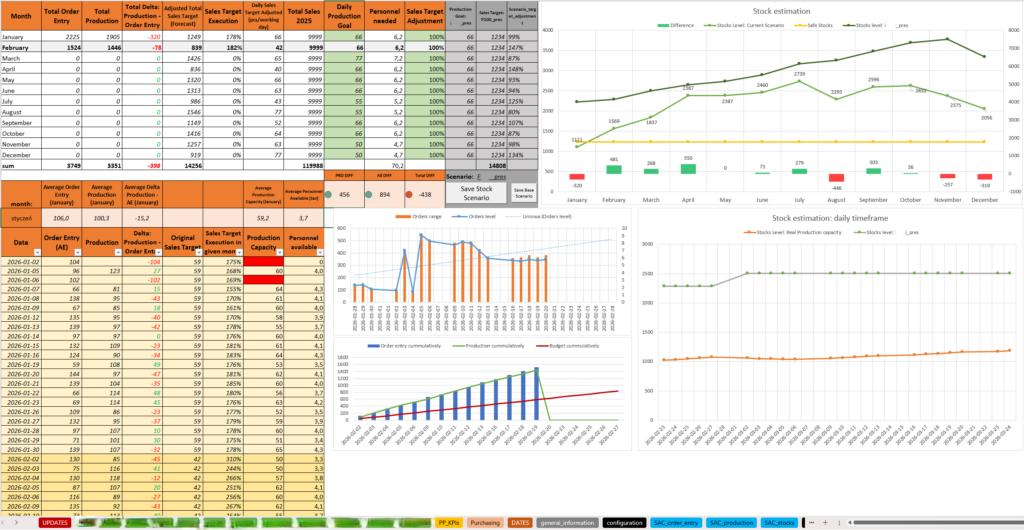
Raz dobrze zrobione formatowanie zadziała zawsze w przyszłości w sposób powtarzalny i przewidywalny. Niezależnie od tego, czy będzie to związane z włączeniem kolejnego obszaru, czy przygotowaniem pliku na kolejny rok.
Customizacja
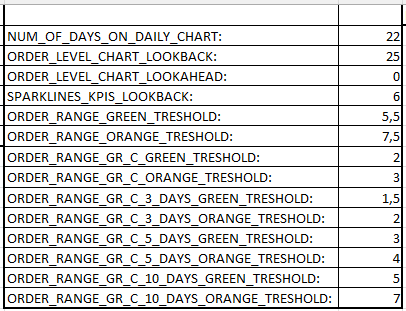
Zakresy wykresów dopasowują się dynamicznie — zawsze jest to np. X dni w przód oraz Y dni w tył. Z technicznego punktu widzenia nic nie stoi na przeszkodzie, żeby wartości X i Y mogły być edytowane przez użytkownika. Warto pójść w tym kierunku z następujących powodów:
- w fazie koncepcji wartości takich parametrów mogą być niejasne, wyklarują się raczej w drodze empirycznych doświadczeń,
- edytowanie skomplikowanych formuł w przyszłości będzie bardzo żmudne,
- menedżerowie mogą szybko dostosować plik do swoich preferencji.
Na poniższym obrazku pokazuję arkusz configuration, w którym znajdują się nie tylko zmienne z zakresami wykresów ale również progi formatowania dla wskaźników KPI.
Poprawność obliczeń
Ta część jest bardzo ważna. Przy podejmowaniu decyzji dotyczących funkcjonowania całych zakładów produkcyjnych jedno jest pewne — dane, z którymi pracujemy muszą być rzetelne i wiarygodne.
Niedopuszczalna jest sytuacja, w której wstawienie jednego wiersza zaburza jakieś obliczenia. Czy też przy uruchomieniu pliku na kolejny rok nie mamy pewności czy w podsumowaniu sprzedaży z Marca wliczone są tylko dane z Marca czy może formuły zahaczyły też część Kwietnia (bo zmieniła się ilość dni w poszczególnych miesiącach).
To generuje niepotrzebny stres, brak zaufania do danych oraz zbędny wysiłek operacyjny polegający na “doglądaniu” czy wszystko się zgadza.
Zdecydowanie warto jest poświęcić czas na opracowanie “odpornych formuł”. Będą one nieco bardziej złożone, ale zapewnią wiarygodne dane i przewidywalność. A to dla kadry menedżerskiej jest nieocenione.
Poprawność danych
Doskonałości operacyjnej nie osiąga się dzięki ładnym wykresom i raportom. Danym należy przede wszystkim nadać odpowiedni kontekst. W tym konkretnym przypadku celem było wzmocnienie jakości decyzji po stronie produkcji. Należało więc zapewnić dane wpisujące się w kontekst procesów produkcyjnych.
Czy to ma jakieś znaczenie? W praktyce różnica może być kolosalna. Wejście zamówień z czysto biznesowego punktu widzenia odpowiada liczbie nowych zleceń na produkty gotowe znajdujące się w cenniku. Tak będą na to patrzeć działy komercyjne — takie jak sprzedaż czy marketing.
Jaka będzie zatem perspektywa produkcji? Tutaj optyka nieco się zmienia — zaczyna nas interesować wszystko to, co wpływa na capacity linii i jest produkowane w takcie razem z wyrobami gotowymi. A to oznacza, że np.:
- półprodukty przygotowywane na inną linię montażu,
- części serwisowe (zbliżone pracochłonnością do wyrobu gotowego — np. kompletny moduł napędowy lub podzespół wymienny)
… powinny zostać uwzględnione w modelu danych.
Rezultat? Model danych w SAP Data Sphere, na podstawie którego działa główny raport wejścia zamówień i produkcji jest z punktu widzenia tego konkretnego narzędzia daleki od ideału. W pierwszej kolejności należało dostosować model danych do tego konkretnego przypadku ich użycia. Wykorzystanie istniejących danych “w ciemno” uniemożliwiłoby uzyskanie rzeczywistego obrazu operacji.
Automatyczne pobieranie danych
Trudno jest mi wyobrazić sobie większe marnotrawstwo, niż przepisywanie danych z raportu do innego narzędzia z warstwą analityczną. W tym konkretnym przypadku dane z SAP Data Sphere są pobierane bezpośrednio do narzędzia zbudowanego w pliku Excel. Wszystko odbywa się z poziomu Excela.
Takie rozwiązanie redukuje do minimum czas niezbędny na aktualizację. To bardzo ważne, ponieważ plik powinien być aktualizowany codziennie — w tym przypadku dodawany jest poziom produkcji oraz wejścia zamówień z dnia poprzedniego.
Stronę techniczną tego rozwiązania opiszę szerzej w rozdziale poświęconym architekturze.
Wskaźniki KPI
Przedstawienie syntezy procesów operacyjnych za pomocą kilku wskaźników liczbowych nie jest wcale oczywiste. I z całą pewnością każdy przypadek wymaga tutaj indywidualnego podejścia. Nawet sam proces planowania produkcji w każdym przedsiębiorstwie wygląda zupełnie inaczej — i będzie wymagał innych wskaźników, które go zdefiniują.
Myśląc o KPI w kontekście planowania produkcji natychmiast przychodzi do głowy mnóstwo parametrów, które mogłyby zostać wykorzystane. Jak zatem wybrać te właściwe?
Przede wszystkim warto określić, jaki obraz chcemy ujrzeć — jaka informacja o operacjach przedsiębiorstwa ma być dostarczona? W narzędziu wspierającym planowanie produkcji naprawdę kluczowa była jedna rzecz:
Synteza tego, co planiści produkcji widzą w SAP-ie na poziomie operacyjnym.
I tutaj pojawiają się dalsze pytania, które prowadzą do ostatecznego kształtu wykorzystanych wskaźników:
- Czy zdolności fabryki są wystarczające do zrealizowania wszystkich otwartych zleceń?
- Czy mamy z czego układać plany produkcyjne?
- Czy produkujemy głównie pod zlecenia klientów czy uzupełniamy magazyny?
- W jaki sposób wcześniej zidentyfikować problemy, które kiedyś dostrzegliśmy zbyt późno?
Wierzę, że w przypadku wyboru właściwych wskaźników sprawdza się powiedzenie: “Less is more.”. W tym projekcie, do monitorowania operacyjnego planowania produkcji, wybrano następujące parametry:
- poziom zamówień — ile jednostek wyrobu gotowego należy wykonać, aby zrealizować wszystkie otwarte zlecenia klientów oraz wypełnić zapasy bezpieczeństwa
- poziom zamówień GR C — ile jednostek wyrobu gotowego należy wykonać, aby zrealizować wszystkie otwarte zlecenia klientów
- poziom zamówień GR C 3/5/10 dni — ile jednostek wyrobu gotowego należy wykonać, aby zrealizować wszystkie otwarte zlecenia klientów, których data wysyłki jest zaplanowana za 3/5/10 dni roboczych
- zasięg — do każdego z powyższych wskaźników obliczany jest zasięg (ile dni roboczych potrzeba, aby wykonać daną ilość wyrobów)
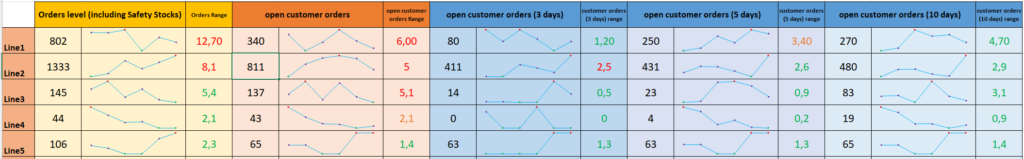
Przykład z powyższej grafiki: Na najbliższe trzy dni mamy do wyprodukowania 411 szt. produktów, na co potrzebujemy 2,5 dnia roboczego (Obszar Line2). Oznacza to, że mamy niewielką przestrzeń na nowe zlecenia i uzupełnianie magazynów. Problemy mogą się pojawić szczególnie w sytuacji niespodziewanych nieobecności personelu produkcyjnego.
Zarządzanie scenariuszowe
Planowanie produkcji w kilkumiesięcznym horyzoncie czasowym to przede wszystkim:
- korygowanie oczekiwanej sprzedaży (poniżej czy powyżej celu? — tylko, jeśli są ku temu wyraźne sygnały z rynku),
- ustalanie odpowiedniego celu produkcyjnego dla poszczególnych miesięcy.
To pozwala sterować poziomem zapasów tak, żeby:
- dobrze przygotować się na sezon wysokiej sprzedaży,
- ilość wyrobów nie przekraczała fizycznych możliwości ich przechowywania.
Oczywiście, w praktyce zarówno rzeczywista produkcja, jak i sprzedaż, odbiegają od przyjętych założeń. W planowaniu niezbędne jest więc podejście iteracyjne — cykliczne korygowanie kursu.
Jest też wiele czynników i zmiennych, za sprawą których możemy realizować różne scenariusze — w zależności od sytuacji i okoliczności. Przykłady:
- sezon urlopowy,
- przekazania personelu pomiędzy zakładami produkcyjnymi,
- planowany maintenance.
Odpowiedzią na te potrzeby jest zastosowanie rozwiązania, które umożliwia zapisanie dowolnej liczby scenariuszy oraz przełączanie się między nimi. Daje to możliwość wyświetlania dowolnego zestawu celów produkcyjnych oraz sprzedażowych wraz z estymowanym przebiegiem zapasów.
Takie podejście pozwala w każdej chwili wrócić do ustaleń z dowolnego spotkania, co systematyzuje cały proces oraz skraca czas podejmowania decyzji. Daje to również możliwość zaobserwowania odchyleń od założonego scenariusza i podejmowanie odpowiednich reakcji.
Dobre symulacje bazujące na wiarygodnych danych zmieniają jakość rozmów. W tym miejscu kończy się gdybanie i bazowanie na domysłach, a zaczyna merytoryczna dyskusja. To z kolei może prowadzić do trudnych wniosków i decyzji, takich jak: zwiększanie lub redukcja personelu. Z punktu widzenia managera planowania i innych decydentów, wiarygodność danych jest w takich sytuacjach kluczowa.
Jest coś jeszcze. Benchmarkiem dla omawianego procesu średnioterminowego planowania może być z całą pewnością proces S&OP (Sales and Operations Planning). Uporządkowany w omawiany tutaj sposób (pod kątem danych, decyzji itd.) proces planowania (proces — nie tylko narzędzie), pozwolił odkryć braki systemowe w kontekście S&OP. Przykład? Uwypuklony został wyraźny brak wymiany informacji pomiędzy produkcją, a sprzedażą na poziomie strukturalnym. To otwiera kolejne drzwi do dalszego rozwijania systemu planowania oraz wprowadzania kolejnych elementów S&OP.
Architektura
W tym rozdziale skoncentruję się mocniej na aspektach technicznych. Pokażę, jakie rozwiązania pozwoliły stworzyć z Excela hub danych niezbędnych w planowaniu średnioterminowym.
Pobieranie danych bezpośrednio z Data Sphere do Excela
SAP Data Sphere pełni funkcję źródła danych dla części informacji (wejście zamówień, produkcja, aktualny zapas). Dotychczas te dane były codziennie spisywane z raportu w SAC (SAP Analytics Cloud) — zbudowanego na danych z Data Sphere. Cyfr do przeniesienia było dość dużo, ponieważ każdy obszar produkcyjny jest rozpatrywany osobno.
W nowym procesie dane pobierane są bezpośrednio z SAP Data Sphere za pomocą specjalnego dodatku do Excela — SAP Analytics Cloud. Umożliwia on wstawienie do Excela odpowiednio skonfigurowanej tabeli z danymi, którą można w dowolnej chwili odświeżyć (rys. 5).
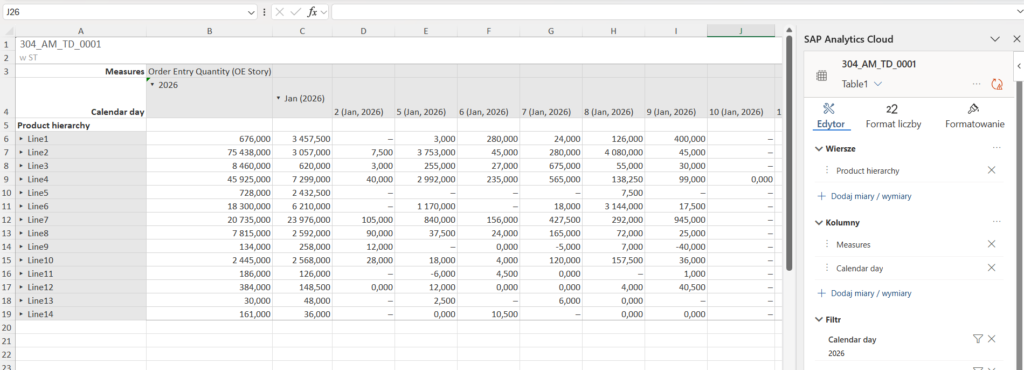
Co ważne, taka tabela składa się z “normalnych” komórek Excela. Można więc na niej pracować wykorzystując VBA. Dzięki temu zbieranie danych (wejście zamówień oraz produkcja na każdy dzień) składa się z prostych trzech kroków:
- Otwarcie pliku z narzędziem i zalogowanie się do tenanta SAP Analytics Cloud w dodatku Excel.
- Odświeżenie wszystkich tabel.
- Uruchomienie makra, które:
- przechodzi przez wszystkie arkusze główne z grupami produktów w Excelu oraz
- do każdego dnia roboczego z przeszłości odszukuje wartość produkcji (lub wejścia zamówień) w tabeli z Data Sphere i wpisuje ją do arkusza głównego.
Eksport danych z SAP-a
Nie wszystkie dane były dostępne w modelu SAP Data Sphere. Do poprawnego obliczenia wskaźników KPI konieczne były dane na poziomie SKU:
- ilość otwartych zleceń (wraz z datą wysyłki),
- ilość produktów będących w transporcie intercompany,
- aktualny poziom zapasu i
- poziom zapasu bezpieczeństwa w poszczególnych magazynach dystrybucyjnych.
Powyższe informacje pobierane są z SAP-a za pomocą automatycznego eksportu danych ze standardowych oraz customizowanych transakcji. Codziennie około godz. 5 rano tworzone są pliki .csv, które można wykorzystać w każdej chwili do obliczeń za pomocą skryptu Python.
Aktualizacja pliku
Codzienna aktualizacja pliku jest wykonywana bezpośrednio w Excelu i sprowadza się do zalogowania tenanta we wtyczce SAP Analytics Cloud i odświeżenia tabel z danymi, a następnie uruchomienia trzech makr:
- Order Entry Update — aktualizacja wejścia zamówień na podstawie danych z Data Sphere. Zgodnie z opisem w rozdziale Pobieranie danych bezpośrednio z Data Sphere do Excela.
- Production Update — jw. dla danych produkcyjnych.
- KPI Update — makro uruchamia skrypt Python (Jak połączyć VBA z Pythonem), który wczytuje dane do biblioteki
Pandas, a następnie oblicza wskaźniki zgodnie z przyjętą metodologią i przenosi je do Excela. Po tej operacji wskaźniki są natychmiast wyświetlane w dashboardzie KPI.
Dodatkowo, na początku każdego miesiąca należy uruchomić dodatkowe dwa makra, które:
- Aktualizuje poziom zapasów tak, żeby w symulacjach na kolejne miesiące odnosić się do rzeczywistej ilości produktów dostępnych na magazynie.
- Pobranie otwartych zleceń tak, żeby uwzględnić zaplanowane wysyłki w symulacjach kolejne dni i miesiące.
To wszystko. Przygotowanie kluczowych do planowania produkcji danych w jednym pliku zajmuje około 2-3 minut (dla 6 obszarów produkcyjnych) i może być wykonywane na poziomie operacyjnym. Jakość danych oraz poprawność i powtarzalność obliczeń zapewniają skrypty.
Zakresy dynamiczne i skalowalność
Jednym z założeń projektu była bezobsługowość narzędzia na jak najwyższym poziomie. Nie chodzi tutaj tylko o automatyczne zbieranie danych. Prosta obsługa to też formuły, które są odporne na zmianę miesiąca czy wykresy, które zawsze pokazują zdefiniowany zakres dat (np. 5 dni wstecz – 15 dni wprzód). Takie podejście eliminuje mnóstwo czynności obsługowych związanych z plikiem i pozwala oszczędzić czas.
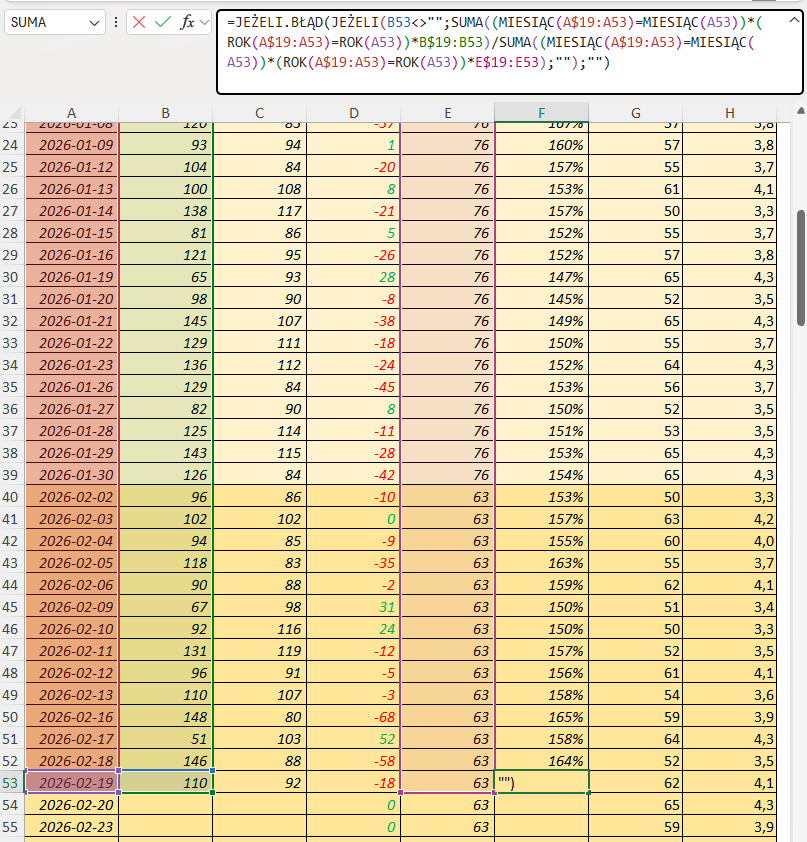
W tym celu można wykorzystać m.in. formuły tablicowe oraz nazwy zdefiniowane w Excelu. Poniżej pokazuję przykład takiej odpornej formuły — służy ona do obliczania realizacji celu sprzedażowego w danym miesiącu na dany dzień. Jest to jedna formuła “przeciągnięta” na cały zakres dni w roku. Pomimo tego, zawsze liczy iloraz sumy sprzedaży oraz celu tylko za dany miesiąc.
Bardzo pomocny jest też Menedżer Nazw, za pomocą którego można zapisać wiele takich skomplikowanych formuł zwracających zakresy dynamiczne, a następnie wykorzystać je np. w wykresach. W tym projekcie lista zdefiniowanych nazw jest ogromna, a ich funkcja jest kluczowa — po cichu, w tle dbają o to, żeby prezentowane dane odzwierciedlały aktualny obraz operacji.
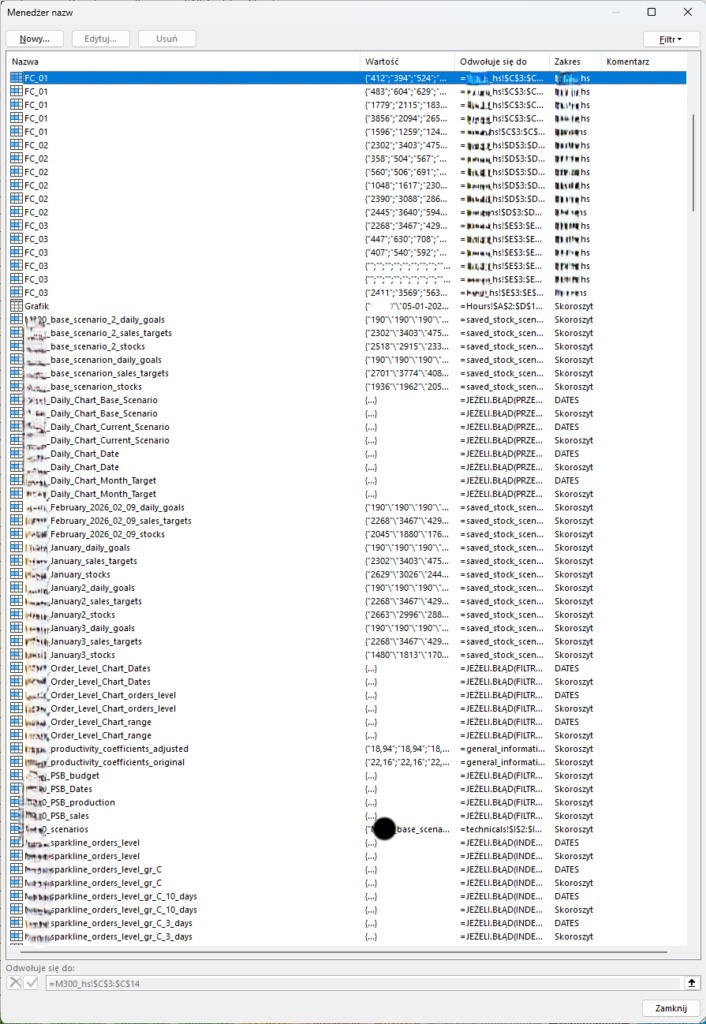
W jaki sposób zarządzać taką liczbą nazw i się w tym nie pogubić? Dane Menedżera Nazw można edytować z poziomu VBA. W tym przypadku skalowalność zapewnia kilka makr, które przygotowują dwa arkusze (główny i pomocniczy) oraz m. in.:
- tworzą nazwy z dynamicznymi zakresami dla tych arkuszy,
- dopasowują odwołania w formułach znajdujących się w arkuszach.
To wszystko składa się na spójny system, który z jednej strony zapewnia bezobsługowość (co czyni go nieco bardziej skomplikowanym), a z drugiej strony jest skalowalny (co pozwala o tym skomplikowaniu zapomnieć podczas użytkowania).
Podsumowanie
W tym wpisie pokazałem, w jaki sposób można uporządkować zarządzanie operacjami bez dużych inwestycji w kosztowne rozwiązania IT. Naturalnie, omówiłem tylko najistotniejsze elementy procesu, bez głębokiego wchodzenia w szczegóły. Cichym bohaterem pierwszego planu stał się tutaj MS Excel, który pełni następujące funkcje:
- huba danych,
- warstwy analitycznej oraz
- narzędzia do wizualizacji.
Ogólnie rzecz ujmując narzędzie składa się z 5 elementów:
- Data Sphere
- Export z SAP
- VBA
- Python
- Arkusz Kalkulacyjny
Ale narzędzie to nie wszystko. Pozwala ono jedynie zmaterializować (a może zcyfryzować?) cały proces koncepcyjny. Zamiast Excela mógłby to być równie dobrze np. Power BI lub dedykowany system zaprojektowany specjalnie do tego celu.
Uważam, że dobrze zrobiony i przemyślany Excel może wygrać z każdym profesjonalnym systemem, który został wdrożony byle jak. I vice versa. Zainwestowanie pieniędzy w drogie narzędzia wcale nie musi przynieść rozwiązania problemów operacyjnych. Da jedynie narzędzia, a to połowa sukcesu — pełen sukces to poprawne ich wdrożenie.
Excel jest dobrym narzędziem, żeby wystartować z czymś nowym i sprawdzić, czego tak naprawdę potrzebujemy. Później, już bardziej świadomie, można takie rozwiązania przenosić do narzędzi klasy enterprise np. Power BI.
Naturalnie, zdecydowanie lepiej jest pracować z narzędziami klasy enterprise. Podkreślam jedynie ten rozdźwięk pomiędzy dużymi inwestycjami w oprogramowanie, a tym co jest naprawdę ważne — poprawnymi danymi i obliczeniami. W zarządzaniu operacjami liczy się kontekst i zrozumienie danych, a nie kolorowe wykresy, czy ładny interfejs.
Niezależnie od wykorzystanego oprogramowania i środowiska, w którym pracujemy kluczowe wydaje się przejście przez następujące punkty (kamienie milowe projektu):
- Rozpoznanie potrzeb i odpowiedź na pytanie — Jaki problem rozwiązujemy?
- Zebranie najważniejszych założeń.
- Identyfikacja połączeń nowego procesu z procesami już istniejącymi — Wkomponowanie nowego procesu w istniejący system.
- Sformułowanie jasnej definicji ról oraz celów.
- Projekt i budowa narzędzia.
- Zebranie danych.
- Zapewnienie warstwy analitycznej.
- Stworzenie warstwy wizualizacji.
- Szkolenie interesariuszy.
Pierwsze cztery punkty to proces koncepcyjny — to tutaj wszystko się rozstrzyga i klaruje. W ramach tych czterech punktów staje się jasne, jakich danych będziemy potrzebować, kto będzie uczestniczył w procesach decyzyjnych oraz co będzie celem (np. spotkań operacyjnych).
Narzędzie jest dopiero później — to kolejny krok, który powinien być realizowany metodycznie, zgodnie z opracowanym wcześniej planem.
I to jest ten punkt, w którym łatwo popełnić błąd. Często się zdarza, że firmy chcą wychodzić od narzędzia, a nie od koncepcji całego procesu, np.:
- Zaplanujmy cykliczne spotkania! — Ale po co? Jaki jest ich cel? Czy ten cel jest osiągalny bez umocowania tego w istniejącej strukturze?
- Zbudujmy raport / wykres! — Świetnie. A jaki problem chcemy dzięki temu rozwiązać? Obraz czego ma on przedstawiać?
Upraszczając, można powiedzieć, że w dążeniu do doskonałości operacyjnej kwestia doboru narzędzi i inne aspekty techniczne nigdy nie powinny wyprzedzać pracy koncepcyjnej.
Zamykając ten wpis, chciałbym poświęcić chwilę temu, co się zmieniło. W tym konkretnym przypadku największą korzyścią z wdrożenia procesu średnioterminowego planowania produkcji była synchronizacja metod planowania i procesu decyzyjnego dla wszystkich zakładów produkcyjnych. W praktyce oznacza to:
- Jeden standard — to samo narzędzie, ta sama interpretacja danych, różnią się jedynie cyfry.
- Identyczna struktura spotkań we wszystkich zakładach produkcyjnych z jasno zdefiniowanymi rolami i celami.
To jest ważne szczególnie na poziomie executive oraz upper management — tam potrzebny jest jeden obraz wszystkich zakładów, przedstawiony w identycznej formie.
To również bardzo mocno poprawia skuteczność komunikacji i jakość podejmowanych decyzji na poziomie middle managementu. Przykład: Jeśli poziom zapasów wyrobów gotowych na magazynie osiąga wysokie wartości, naturalną reakcją jest hamowanie produkcji. Dobrze zorganizowany proces średnioterminowego planowania powinien w takiej sytuacji dawać odpowiedź na pytania:
- dlaczego zapasy rosną?
- czy budujemy je zgodnie z przyjętą wcześniej strategią?
- na co się przygotowujemy?
- jakie będą konsekwencje, jeśli nie zbudujemy tych zapasów?
Odpowiedzi na takie pytania potrafią zmienić perspektywę i dokładnie to zapewnił ten proces. A to z kolei pozwoliło zastąpić intuicję dowodami. Dla organizacji jest to kolejny krok w kierunku Data-driven management.
Uporządkowany proces to również oszczędność czasu. Wcześniej w jednej fabryce dane przygotowywał szef zakładu we własnym Excelu. W innej — planiści produkcji zbierali dane z różnych źródeł do zupełnie innego pliku. Dodatkowo, raz w miesiącu trzeba było “dopilnować” zakresów w wykresach, zajmował się tym najczęściej kierownik planowania chwilę przed spotkaniem z przedstawicielami produkcji. Całość z pewnością zajmowała więcej niż 10 minut dziennie, przy czym jakość danych była znacznie niższa, a wskaźników KPI nie było w ogóle.
Teraz za przygotowanie danych dla 17 obszarów produkcyjnych w dwóch fabrykach odpowiada jedna osoba na poziomie operacyjnym. Dla każdego z obszarów potrzebujemy produkcji, wejścia zamówień oraz 5 wskaźników KPI. To łącznie około 120 danych z różnych źródeł każdego dnia. Niektóre z nich (wskaźniki) są wyliczane na podstawie danych z tabeli zawierających kilkadziesiąt tysięcy wierszy.
Całość zajmuje około 10 minut dziennie. Myślę, że to akceptowalna cena za dobrej jakości dane, które realnie wspierają procesy decyzyjne i poprawiają komunikację na poziomie managerskim.
Na sam koniec jedna istotna uwaga. Co zrobić, żeby taki proces działał po jego wdrożeniu? Moim zdaniem musi on mieć jednego właściciela, najlepiej odpowiednio umocowanego w strukturze organizacji. W przeciwnym razie istnieje duże ryzyko, że będzie to tylko “coś dodatkowego”, co z czasem doprowadzi do powrotu do dawnych metod, narzędzi i nawyków.