Problem: Ponad 100 nieustandaryzowanych plików, które wspierają zamawianie materiałów. Każdy z nich jest aktualizowany średnio raz w tygodniu przez kupca operacyjnego, który pobiera dane manualnie z SAP-a. W praktyce oznaczało to, że każda nieobecność utrudniała przejęcie obowiązków przez inną osobę.
Stan obecny
Problem, który opisałem to klasyczna sytuacja w firmach produkcyjnych. Kilkuosobowy zespół, w którym pracownicy odpowiadają za określone grupy dostawców. Każdy kontrahent ma swój dedykowany plik Excel. Wszystkie pliki są do siebie podobne, ale nie są ustandaryzowane.
Fakt, że manualne przygotowanie tych danych zajmuje kilka godzin tygodniowo, często pozostaje niezauważony. Nie można się temu dziwić — z punktu widzenia każdego specjalisty z osobna jest to po prostu praca, którą trzeba wykonać. Część dostawców ma swoje wyjątkowe ograniczenia, które trzeba spełnić. Dodatkowo pliki rozrzucone są po różnych lokalizacjach. Trudno tutaj dostrzec wspólny mianownik.
Jak to działa
Każdy z plików zawiera następujące dane pobierane z systemu SAP:
- otwarte zamówienia,
- aktualny poziom zapasów,
- średnie zużycia.
Dane pobierane są manualnie z takich transakcji jak: ZEK103, MB52, MB51 lub transakcje niestandardowe typu Z. Źródła danych nie są uzgodnione — każdy robi to na swój sposób, co w pewnych sytuacjach może prowadzić do niespójnych wyników.
Każdy plik aktualizowany jest osobno, w sposób manualny. Odpowiednie formuły wyliczają zasięg zapasów oraz symulują ich poziom w kolejnych dniach. W osobnym arkuszu na podstawie parametrów takich jak: Lead Time (LT), Minimum Order Quantity (MOQ) itd. obliczane są ilości materiałów, które trzeba zamówić. Kupiec potwierdza dane i tworzy zamówienie w SAP-ie.
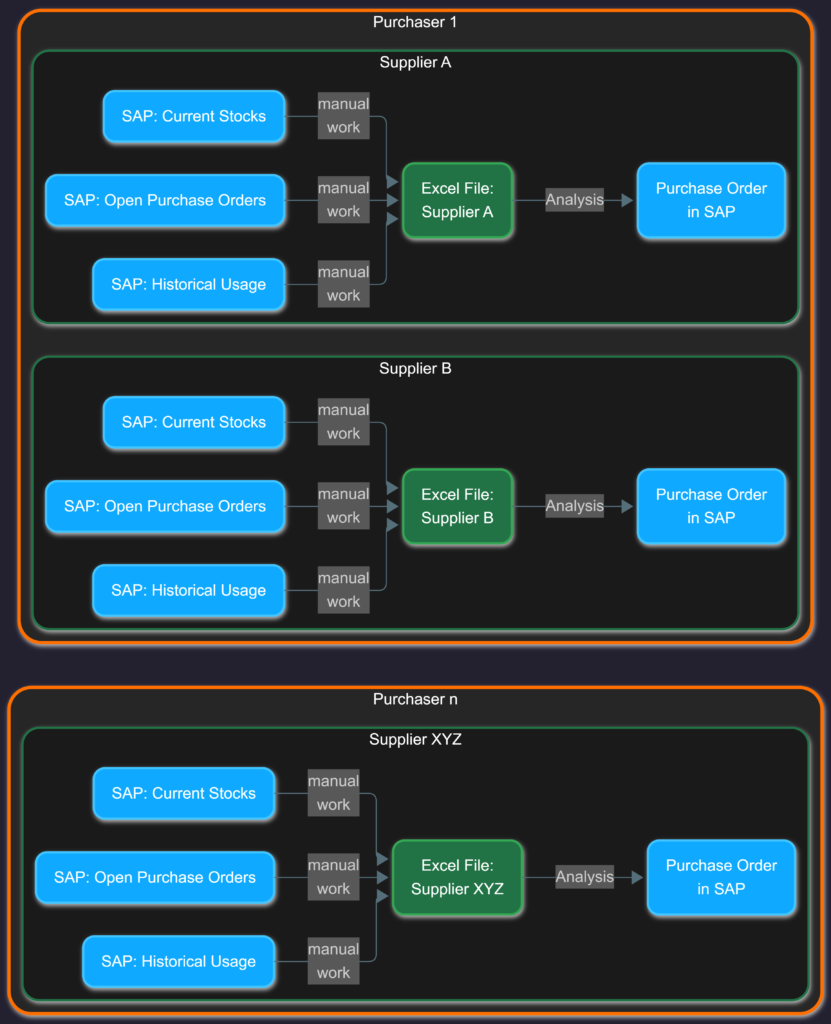
Dopiero spojrzenie na cały proces z góry, z perspektywy tzw. helicopter view, pozwoliło mi zauważyć, że wszystkie operacje związane z plikami dostawców to tak naprawdę jeden wyraźny podproces całego procesu zakupowego. Sensowne było więc jego świadome ustandaryzowanie, a następnie zautomatyzowanie w możliwie jak największym stopniu.
Najpierw standaryzacja, później automatyzacja
Dlaczego możliwość automatyzacji była w tym przypadku taka nieoczywista i co ma to wszystko wspólnego z zasadą Pareto? Zamówienia dla pewnej grupy dostawców (~10-20%) wymagały dodatkowych obliczeń lub innych operacji, wynikających np. z tego, że:
- jeden materiał zamawiany jest od kilku dostawców,
- trzeba zoptymalizować transport (dopasowanie zamówienia do pełnej ciężarówki),
- itp.
Właśnie dlatego standaryzacja procesów jest tak ważna. Warsztaty z jasno określonym celem: ustandaryzowanie procesu zamawiania materiałów od dostawców pozwoliły:
- zdefiniować grupę ~80% plików, w których zasady są niemal identyczne,
- opracować minimalistyczny wygląd pliku, a także standard jego nazwy i lokalizację,
- pogrupować pozostałe pliki i określić, jakie reguły w nich obowiązują,
- zdefiniować wspólne źródło danych (konkretne transakcje SAP),
- ujednolicić sposób obliczeń średniego zużycia (jaki okres powinien być analizowany).
Dopiero po takim usystematyzowaniu procesu można sięgnąć po tzw. low-hanging fruits i przystąpić do automatyzacji największej grupy plików.
Kolejny krok — automatyzacja całego procesu biznesowego
Po działaniach związanych ze standaryzacją mamy pełen obraz procesu. Istotą są tutaj dane — wiemy już, które transakcje SAP (i przy jakich parametrach: storage locs, movement types itd.) je dostarczą. W tym przypadku postawiłem na automatyczny eksport danych z SAP-a do pliku (codziennie w nocy).
Generowanie tak potężnych raportów (zwłaszcza dla historycznych zużyć) w jednym przebiegu nocnym obciążało system i generowało zbyt duże pliki. Rozwiązaniem okazało się podzielenie dostawców na kilka grup zakupowych i generowanie kilku plików — dla każdej z nich osobno.
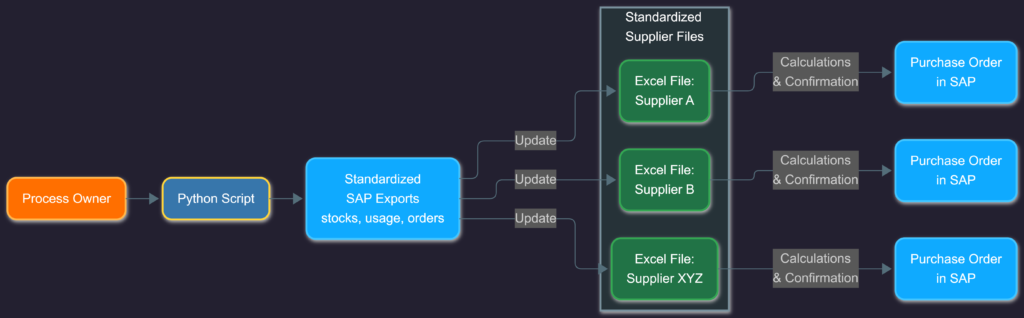
Sercem automatyzacji i całego rozwiązania jest skrypt Python, który:
- Wczytuje dane z plików wyeksportowanych z SAP-a.
- Iteruje po wszystkich plikach dostawców w katalogu. Z ustandaryzowanej nazwy odczytuje kod zakładu oraz nazwę dostawcy. Na tej podstawie (dzięki mapie znajdującej się w pliku pomocniczym), program “wie”, które dane należy wykorzystać.
- Przetwarza dane: konsolidując je i filtrując zgodnie ze zdefiniowaną logiką biznesową.
- Otwiera kolejno każdy plik i aktualizuje dane w odpowiednich komórkach Excela (przypisując je na podstawie numeru SAP materiału).
Dodatkowo, kilka makr VBA uruchamianych automatycznie podczas otwierania plików dba o to, żeby użytkownik nie musiał martwić się usuwaniem kolumn z przeszłymi datami lub dodawaniem nowych tak, żeby analiza obejmowała zdefiniowany przyszły okres (np.: 60 dni).
Rozwiązanie jest w pełni skalowalne. Aby dodać nowego dostawcę wystarczy:
- uwzględnić jego dane w wariantach SAP, z których eksportowane są dane,
- dodać plik dostawcy do katalogu (z numerami SAP materiałów),
- zaktualizować mapę (łączącą dostawcę z grupą zakupową).
Nieważne, ile plików będzie w katalogu. Proces zawsze będzie wyglądał tak samo — jedna osoba uruchamia rano skrypt, który aktualizuje wszystkie niezbędne dane.
Podsumowanie i kolejne kroki
Takie spojrzenie na proces end-to-end i uporządkowanie go to czyste złoto z punktu widzenia zarządzania całym łańcuchem dostaw. Dzięki temu, że wszystkie pliki są ustandaryzowane i zawsze aktualne, a do tego znajdują się w jednym miejscu, płynność przekazywania obowiązków (np. w czasie urlopów czy rotacji w zespole) jest bezstresowa.
Naturalnie, wdrożenie przynosi konkretne i mierzalne korzyści biznesowe. Dla 90 plików włączonych już do nowego systemu zyskujemy:
- Uwolnienie czasu operacyjnego: Oszczędzamy około 7,5 godziny tygodniowo (każdy plik aktualizowany raz w tygodniu, średnio 5 minut manualnej pracy). W skali roku to blisko 400 godzin, które kupcy mogą przeznaczyć na realne działania strategiczne, a nie mechaniczne „klikanie”.
- Eliminację ryzyka human error: Całkowicie odcięliśmy ryzyko pomyłek przy manualnym pobieraniu i aktualizowaniu danych. Kupcy pracują na sprawdzonych, jednoznacznych liczbach.
- Jedno źródło prawdy (Single Source of Truth): Ujednolicenie transakcji SAP i logiki wyliczania zużycia oznacza, że cała organizacja patrzy na te same wskaźniki w ten sam sposób.
Odcięcie 80% powtarzalnego procesu na samym starcie było najlepszą decyzją. Pozwoliło nam to szybko osiągnąć tzw. quick wins i zaprezentować zespołowi realne korzyści. To z kolei znacząco zredukowało naturalny opór przed zmianą, który tak często hamuje inicjatywy z obszaru Continuous Improvement.
Kolejne kroki
W kolejnym kroku — po ustabilizowaniu nowego procesu — skoncentrowałbym się właśnie na tych pozostałych 20%. To wciąż kilkadziesiąt plików, które są obrabiane manualnie. Z całą pewnością, przynajmniej dla części z nich, da się znaleźć wspólną logikę i zautomatyzować.
Automatyzacja nie musi się kończyć na aktualizowaniu danych. Obecnie kupcy operacyjni mają wszystkie niezbędne dane, które muszą przenieść do transakcji ME21N, aby utworzyć zamówienie. Na dalszym etapie warto byłoby zautomatyzować również ten element. Mógłby to wykonać program integrujący się z SAP-em za pomocą np.:
- SAP GUI Scripting,
- PyRFC lub
- integrację przez warstwę middleware (np. Mulesoft).
W wyniku tego usprawnienia otrzymujemy dużą ilość danych, które są ustrukturyzowane i zbierane automatycznie. Mamy też jasno zdefiniowane reguły biznesowe, które są niezbędne do ich wykorzystania. Widzę tutaj potencjał do zastosowania AI, co mogłoby jeszcze mocniej wspierać decyzje zakupowe.
Przykładowo model mógłby sugerować korekty ilości zamawianych materiałów na podstawie sezonowości, historii zmian planu produkcji lub jakości prognoz. Czyniąc cały proces jeszcze bardziej autonomicznym, a rola specjalisty (human in the loop) ograniczałaby się głównie do zatwierdzania ilości zamawianych materiałów.